
DeepSeek V4-Flash正式公测与技术突破
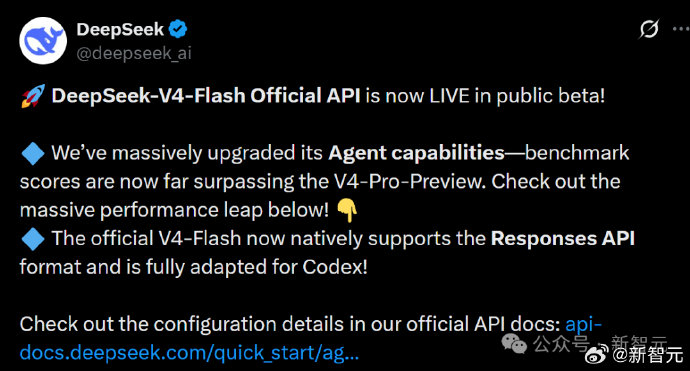
2026年7月31日下午,DeepSeek正式推出V4-Flash-0731版本API公测。该模型在架构上与此前的预览版保持一致,采用MoE架构,总参数量为284B,激活参数为13B,并支持100万token的上下文窗口。
此次升级的核心在于后训练(Post-Training)和Agent框架的优化。数据显示,V4-Flash在DeepSWE软件工程基准测试中得分54.4分,较预览版的7.3分提升了7.5倍;在Terminal-Bench 2.1终端操作测试中获得82.7分;在CyberGym网络安全攻防模拟中得分为76.7分,较预览版翻倍。
与Kimi K3及其他模型的对比分析
在性能与定位方面,DeepSeek V4-Flash与Kimi K3呈现出截然不同的路线:
- 性能与智能:Kimi K3于2026年7月27日完成开放权重发布。在Artificial Analysis智能指数中,Kimi K3 (max) 得分为57,高于DeepSeek V4-Flash的50分。在GDPval-AA v2测试中,Kimi K3取得了1687 Elo的最高开放权重分数,并具备原生视觉能力。
- 规模与资源:Kimi K3是首个达到2.8万亿参数的开放模型,激活参数为104B;而DeepSeek V4-Flash激活参数仅为13B,对受GPU限制的自托管用户更具吸引力。
- 成本与速度:DeepSeek V4-Flash主打极致性价比,API输入价格为1元/百万Token,输出为2元/百万Token,缓存价折扣低至98%。其API成本仅为Kimi K3的几十分之一,且每任务成本比GPT-5.6 Luna (max) 低约60%。
此外,与GLM-5.2相比,V4-Flash在性价比上更具优势,而GLM-5.2则在低延迟结构化工作流和工程落地方面表现扎实。
应用场景与行业影响
根据不同需求,用户的选择逻辑有所差异:追求极致性能、超长文档分析及多模态复杂任务的用户倾向于选择Kimi K3;而个人开发者和中小团队在面对代码修复、终端操作等高频Agent场景时,DeepSeek V4-Flash是优先选择。
行业分析认为,V4-Flash证明了精细化后训练可使轻量模型实现Agent能力的跃升,表明堆参数并非提升能力的唯一路径。
评论区
已通过 0 条 · 审核通过后展示