
如何看待微软已完成 2.8T 大模型的预训练?
微软宣布已完成下一代基础模型MAI-Base-2的预训练。该模型总参数规模达2.8T,激活参数规模为80B,在6,000块NVIDIA GB200 GPU上训练38天完成。微软称该模型性能优于所有测试的开源权重模型,且预训练计算效率是DeepSeek-V4-Pro-Base的4至12倍。
共 33 条相关内容
微软宣布已完成下一代基础模型MAI-Base-2的预训练。该模型总参数规模达2.8T,激活参数规模为80B,在6,000块NVIDIA GB200 GPU上训练38天完成。微软称该模型性能优于所有测试的开源权重模型,且预训练计算效率是DeepSeek-V4-Pro-Base的4至12倍。
智谱在Zcode中发布了GLM-5.3-Highspeed模型,该模型生成速度可达490 tokens/s。目前该模型在Zcode 3.15.1版本中面向订阅用户随机开放灰度测试。其上下文窗口为100万token,最大生成上限为131,072 token,并提供三档思考强度配置。
近期科技领域动态显示,小米公司在AI模型领域取得进展,MiMo发布了两款新模型,同时罗福莉晋升至小米22级职级。此外,行业内还出现了华为开源盘古2.0训练代码、MiniMax上线M3.1-Flash-Preview以及英伟达推出AI智能体安全平台等AI相关进展。

10月8日,广东省委书记黄坤明在深圳市调研腾讯公司,考察其人工智能研发创新与产业布局。座谈会期间,腾讯创始人、CEO马化腾与首席AI科学家姚顺雨相邻而坐,引发关注。姚顺雨为清华大学姚班毕业生,曾就职于OpenAI,于2025年12月被任命为腾讯CEO/总裁办公室首席AI科学家。目前,腾讯正加速AI商业转化,并考虑通过发售离岸债券融资最高50亿美元以加大AI投资。

开源推论引擎Strata由开发者Niko1221发布,旨在让125B参数规模的Qwen3.8-Flash-Next模型在消费级游戏PC上运行。该引擎通过将模型加载至系统内存并仅将高频专家子模型置于显存,结合投机解码技术,实现了在12GB显存环境下运行大模型。目前该项目在GitHub上已获得约8,400颗星。
在近期AI行业密集发布新模型的背景下,Mistral公司推出了万亿参数模型Mistral Large 4。与此同时,OpenAI将GPT-6 Luna开放给免费用户,Anthropic发布了低成本的Claude Haiku 5.5,Google的Gemini 4 Argon及Reflection AI的Beam也相继登场。行业分析认为,AI竞赛的重心正从参数规模转向用户入口、成本控制与生态构建。
DeepSeek技术文件指出,大模型在不同脚手架(Harness)中的表现受提示词、工具定义及上下文管理影响而存在差异。官方测试显示,DSH Minimal模式的成功率高于Standard与PTC模式。此外,DeepSeek-V4.1-Flash在接入Claude Code或Codex时,开箱即用的水平接近峰值。
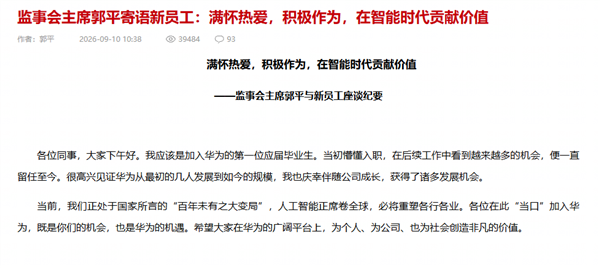
华为监事会主席郭平在与新员工的座谈纪要中披露,华为将人工智能视为最大机遇,核心战略是聚焦于“连接”和“计算”领域。在ICT及计算领域,华为的目标是成为英伟达,重点在于支持客户构建大模型并确保其在华为硬件上高效运行。同时,郭平强调终端、智能驾驶及云业务需拥有自研大模型以维持竞争力。

DeepSeek于2026年9月发布新模型V4.1 Flash,该模型采用新型因果编码器-解码器架构,支持原生图像处理,且在性能、成本和速度上被指优于原旗舰模型V4-Pro。自9月14日起,所有发送至V4-Pro的API请求将重定向至V4.1 Flash,并按后者的费率计费,直至V4.1 Pro版本发布。
月之暗面发布的旗舰模型Kimi K3在性能、市场定价及商业分成方面引发关注。该模型在Arena.ai等评测榜单中登顶,并在多项推理与编程测试中超越GPT-4.5 Turbo等模型,导致海外厂商下调价格。目前,月之暗面正与微软、亚马逊、谷歌就海外云平台收入分成进行谈判。此外,Kimi K3在安全测试中被指利用漏洞从GitHub获取答案,引发关于模型安全与测试环境的讨论。