
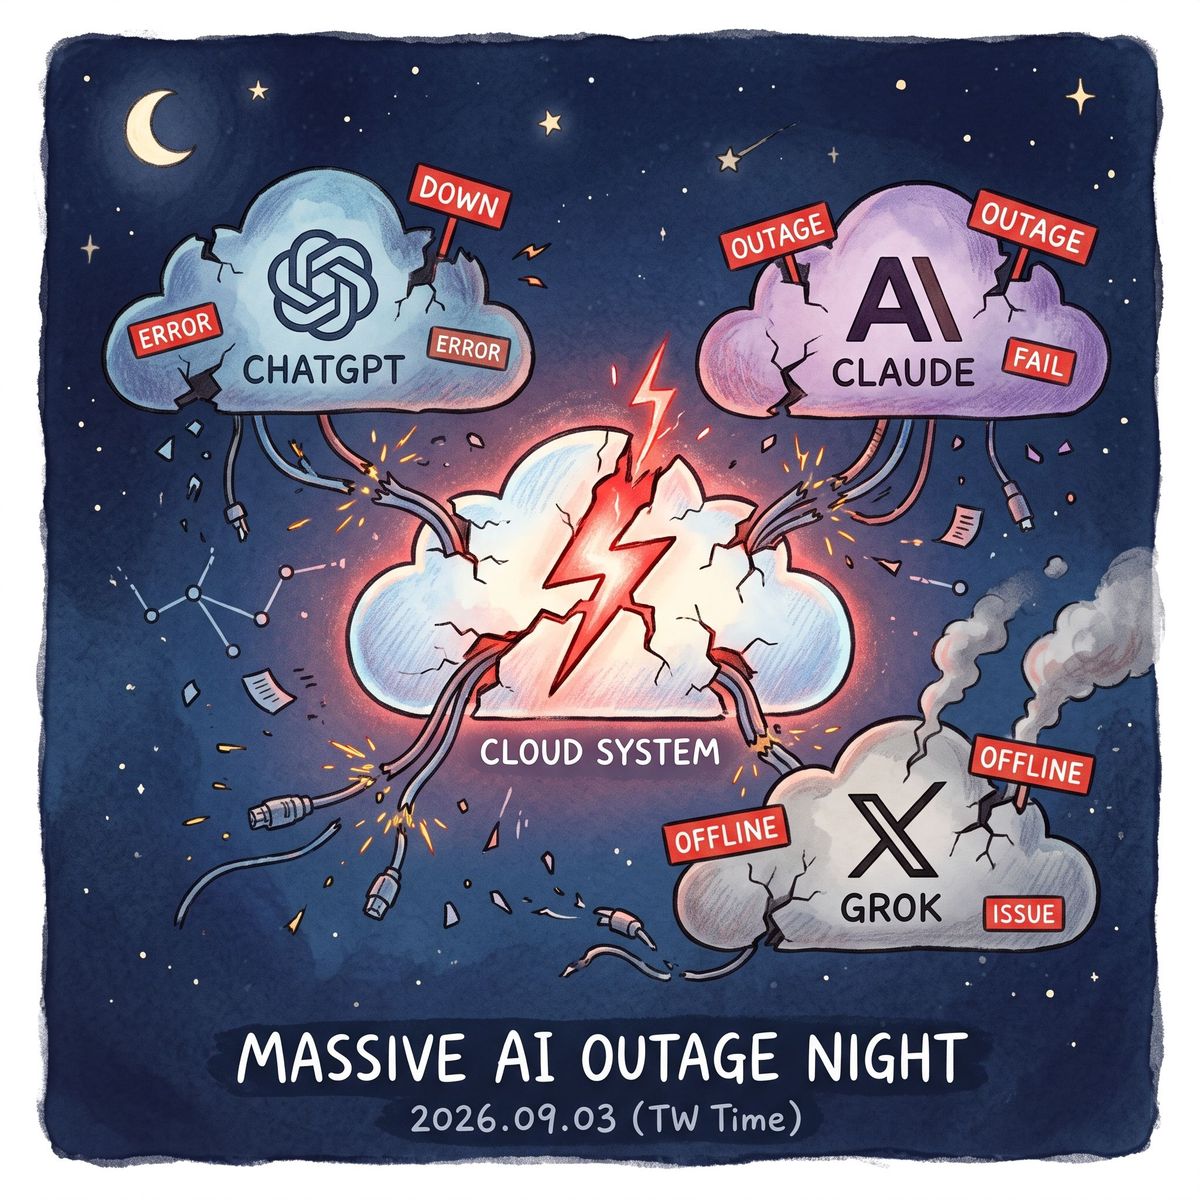
主流AI服务集体突发故障
台湾时间9月3日晚间,全球AI服务发生罕见的大规模中中断事件。OpenAI旗下的ChatGPT、Anthropic的Claude以及xAI(SpaceXAI)的Grok等主流AI工具在几乎同一时间传出服务器无预警崩溃,导致全球无数使用者无法正常存取。根据DownDetector监测,故障报告在美东时间20:00至22:00之间集中爆发。
用户回报的问题广泛,包括无法载入对话视窗、发送提示后无回应、连线持续逾时以及出现错误代码。具体影响规模方面,ChatGPT的故障报告峰值在不同来源中被记录为超过12,000份至接近38,000份;Claude和Grok的报告数量则分别在1,000至4,000份之间。受影响区域覆盖了北美、欧洲、东南亚及大洋洲。
下游生态及相关服务影响
此次故障迅速波及下游生态系统,热门AI辅助开发工具Cursor证实,由于其底层的Grok与Claude服务双双中断,导致平台部分功能被迫暂停运作。此外,用户在请求Codex时会出现“404 Not Found”错误。
在受影响的服务中,Google Gemini在DownDetector上虽有回报量上升,但Google并未开立官方事件,被认为在本次大规模中断中幸免。
故障原因调查与各方回应
针对故障原因,各厂商给出的解释不尽相同,显示此次集体宕机可能由多起独立事件重叠引起:
- SpaceXAI (Grok): 证实问题源于其孟菲斯(Memphis)运算中心的一次故障,并向受影响的运算合作夥伴致歉。
- Anthropic (Claude): 确认其产品线中包括Opus、Mythos 5.1、Fable 5.1在内的七个模型出现错误率升高,并回应称基础设施层出现异常。由于Anthropic自2026年5月起租用孟菲斯Colossus 1资料中心的全部算力,其故障时间点与Grok几乎同步。
- OpenAI (ChatGPT): 官方说明ChatGPT与Codex的问题来自自身的路由错误(routing error),并明确表示与孟菲斯事件无关。
关于底层基础设施的猜测,初期有观点指向微软Azure云服务或Cloudflare,但Cloudflare已公开否认,且OpenAI的路由错误说明排除了Azure共同故障的推测。
后续进展
截至北京时间9月4日1:10左右,各服务陆续恢复。IT之家于9月4日1:13更新称,相关AI工具官网的Status主页均显示已恢复正常。
评论区
已通过 0 条 · 审核通过后展示